
평균 200ms 뒤에 숨은 2.4초
평균 응답시간과 TPS만 보고 합격시킨 성능테스트가 놓치는 것들...
가정해 볼까요? 결제 API를 출시하기 전에 성능테스트를 했고, 보고서에는 이렇게 적혀 있습니다.
| 항목 | 목표 | 결과 |
|---|---|---|
| 평균 응답시간 | 300ms 이하 | 200ms (합격) |
| 최대 TPS (초당 처리한 요청 수) | 1,000 이상 | 1,260 (합격) |
두 숫자 모두 목표를 넘겼으니 그대로 출시합니다. 그런데 첫 주에 ‘가끔 결제가 한참 걸린다’는 문의가 들어옵니다. 평균은 200ms였는데 말이에요.
평균과 TPS는 시험 하나를 숫자 하나로 줄인 값입니다. 줄이는 과정에서 느린 요청, 실패한 요청, 요청을 보내는 방식이 숫자에서 사라질 수 있어요. 이 글에서는 무엇이 어떻게 사라지는지를 그림으로 하나씩 확인합니다.
결론부터 말하면, 평균과 TPS만으로 합격을 판단하지 않고 세 가지를 함께 적습니다. 느린 쪽 1%의 경계인 p99, 오류율, 그리고 TPS를 잰 그 순간의 응답시간입니다.
평균이 같아도 사용자가 겪는 시간은 다릅니다
요청을 100건씩 받은 서비스 A와 B를 비교해 보겠습니다. 평균 응답시간은 둘 다 200ms입니다. 평균은 모든 응답시간을 더해서 요청 수로 나눈 값이에요. 아래 그림은 응답시간 산점도입니다. 점 하나가 요청 한 건이고, 가로는 요청이 끝난 시각, 세로는 그 요청의 응답시간이에요. 초록 선은 그때까지 끝난 요청의 평균입니다.

여기서 볼 것은 초록 선과 점의 높이입니다. 초록 선은 두 서비스 모두 200ms로 끝나지만, A의 점은 선 둘레에 모여 있고 B의 점은 대부분 선 아래 바닥에 붙어 있어요. 선 위에는 2초가 넘는 점 4개만 떠 있고, 200ms에서 2,000ms 사이는 텅 비어 있습니다. B의 초록 선은 이 점이 찍힐 때마다 계단처럼 오릅니다. 요청 100건 중 96건은 평균보다 빠르고, 나머지 4건이 평균을 200ms까지 끌어올린 거예요.
그래서 평균 200ms는 B를 쓰는 사용자 중 누구도 겪지 않은 시간입니다. 96명은 그보다 빨랐고, 4명은 열 배 넘게 기다렸습니다. A는 점이 모두 200ms 근처라서 평균이 실제 경험을 잘 나타내고요.
사용자가 ‘느리다’고 느끼기 시작하는 기준을 500ms로 가정하면 A는 0건, B는 4건입니다. B는 25명 중 한 명꼴이에요.
그렇다면 이 느린 쪽을 숫자 하나로 말하려면 어떻게 해야 할까요?
느린 쪽은 백분위수(percentile)로 봅니다
백분위수는 요청을 빠른 순서로 세웠을 때 일정 비율의 요청이 이 시간 안에 끝난다는 뜻의 값입니다. p99는 99%의 요청이 끝나는 시간이에요. 요청이 100건이면 99번째로 빠른 요청의 응답시간입니다. 도구에 따라 계산 방식이 조금씩 다른데, 이 글에서는 이 방식으로 셉니다. p50은 중앙값이고, p95는 95%의 요청이 끝나는 시간입니다.
서비스 B의 요청 100건을 빠른 순서로 세워서 p50, p95, p99를 짚어 보겠습니다.

가로축은 빠른 순서, 세로축은 응답시간입니다. 막대 96개는 평균 200ms 선 아래에 있다가 마지막 4개에서 갑자기 솟아요. p50은 105ms, p95는 186ms로 평균보다 낮고, p99는 2,421ms입니다. 느린 요청이 4%뿐이라서 p95까지는 보이지 않다가 p99에서 처음 나타납니다.
A와 B를 숫자로 나란히 놓으면 이렇습니다.
| 응답시간 | 서비스 A | 서비스 B |
|---|---|---|
| 평균 | 200ms | 200ms |
| p50 | 194ms | 105ms |
| p95 | 297ms | 186ms |
| p99 | 340ms | 2,421ms |
| 최대 | 379ms | 2,527ms |
| 500ms 넘는 요청 | 0건 | 4건 |
B는 중앙값이 A보다 오히려 낮은데 p99는 약 7배입니다. 평균만 봤다면 둘은 같은 서비스였을 거예요.
같은 이야기는 Google의 SRE 책에도 나옵니다. 초당 1,000건을 처리하고 평균이 100ms인 서비스에서도 요청 1%는 5초가 걸릴 수 있다는 예인데요. 그 경우 나머지 99%의 평균은 (100 − 0.01 × 5,000) ÷ 0.99, 약 50.5ms입니다. 평균 하나로는 이 두 집단이 한 덩어리로 섞여 보입니다.
화면 하나가 호출을 100개 부르면 느린 1%가 화면의 63%가 됩니다
p99가 느려도 요청의 1%뿐이니 괜찮지 않을까요? 사용자가 요청 한 건만 보낸다면 그렇습니다. 하지만 화면 하나를 그리려고 서버를 여러 번 부르면 이야기가 달라져요. 화면은 호출이 모두 끝나야 그려지니까요.
호출 하나가 느릴 확률이 1%이고 호출끼리 서로 영향을 주지 않는다고 가정하면, 호출이 N개일 때 하나라도 느릴 확률은 1 − 0.99^N입니다. 호출이 1개면 1%, 10개면 9.6%, 100개면 63.4%예요.

칸 하나가 화면 한 번이고 빨간 칸이 느린 화면입니다. 호출이 1개일 때는 칸 하나가 빨갛고, 100개일 때는 칸의 절반 넘게 빨갛게 변해요. 호출이 69개부터는 느린 화면이 절반을 넘습니다. 그 지점부터는 호출 하나의 p99가 화면 전체의 중앙값과 비슷해져요.
이 계산은 Jeffrey Dean과 Luiz André Barroso가 쓴 논문 The Tail at Scale(2013)에 나오는 예와 같습니다. 논문은 서버 하나에서는 요청 100건 중 1건이 1초를 넘는데, 서버 100대의 응답을 병렬로 모아야 하는 요청은 63%가 1초를 넘는다고 설명합니다. 실제 서비스에서는 호출들이 서로 영향을 주는 경우가 많아서 이 숫자가 그대로 나오지는 않습니다. 호출이 많을수록 느린 요청을 만날 확률이 커진다는 방향은 같아요.
TPS는 멈춰도 기다리는 시간은 계속 늡니다
이제 TPS를 보겠습니다. 성능테스트 도구에서 TPS를 올릴 때는 흔히 가상 사용자(VU, Virtual User)를 늘립니다. VU는 요청을 보내고, 응답을 받고, 잠깐 쉰 뒤 다시 요청을 보내는 가상의 사용자예요.
시뮬레이션은 이렇게 만들었습니다. 서버는 한 대이고 요청 하나를 평균 0.8ms(처리 시간은 평균이 0.8ms인 난수)에 처리하므로 최대 약 1,250 TPS를 낼 수 있습니다. VU는 응답을 받으면 1초 쉬고 다음 요청을 보냅니다. VU를 125부터 2,500까지 올리면서 TPS, 평균 응답시간, p99를 쟀어요.

위쪽이 TPS이고 아래쪽이 응답시간입니다. 파랑 선이 평균, 빨강 선이 p99예요. 초록 점선은 TPS 목표 1,000이고 주황 점선은 500ms입니다.
- VU 1,125: TPS 1,117로 목표를 넘었고, p99는 30ms입니다.
- VU 1,250: TPS 1,225로 한계에 거의 닿았고, p99는 65ms입니다.
- VU 2,500: TPS 1,262이고, p99는 1,074ms입니다.
VU를 1,250에서 2,500으로 두 배 늘렸더니 TPS는 3%밖에 늘지 않았는데 p99는 약 16배가 됐습니다. 서버가 낼 수 있는 최대치에 닿으면 TPS는 더 오르지 않고, 늘어난 VU는 줄을 서서 기다려요.
이건 VU 수가 TPS 곱하기 (응답시간 + 쉬는 시간)과 같기 때문입니다. VU 2,500은 TPS 1,262 × (0.98초 + 1초)와 맞아떨어져요. TPS가 1,262에 묶여 있으니 VU가 늘면 응답시간이 늘어날 수밖에 없습니다.
그래서 TPS 하나로는 서버가 한계 안에서 일하는지 줄을 세우고 있는지 알 수 없습니다. 1,225와 1,262는 거의 같은 TPS인데 p99는 65ms와 1,074ms입니다. TPS는 그때의 p99와 같이 적어야 뜻이 생겨요. 이 예시에서는 ‘VU 1,750까지 p99 460ms, TPS 1,261’처럼요. VU 1,875에서는 p99가 560ms가 되어 500ms를 넘습니다.
오류가 빨리 돌아오면 평균도 TPS도 좋아집니다
이번에는 서버가 요청을 처리하지 못하고 오류를 돌려주는 경우입니다. 오류 응답은 보통 성공 응답보다 빨리 돌아와요. 성공은 200ms, 오류는 10ms에 돌아오고, 서버는 VU의 요청을 줄 세우지 않고 한꺼번에 처리한다고 가정하겠습니다.
앞 절과는 다른 서버로, VU 180개가 쉬지 않고 요청하는 시험을 가정하겠습니다. 이 시험에서는 TPS가 VU 수를 평균 응답시간(초)으로 나눈 값이 됩니다. VU 하나가 1초에 보내는 요청이 1 ÷ 평균 응답시간(초)건이기 때문이에요. 오류가 없으면 평균이 200ms라서 180 ÷ 0.2 = 900 TPS입니다. 목표 1,000에 못 미치죠. 오류 응답 비율을 0%에서 30%까지 올려 보겠습니다.

막대의 초록 선이 목표입니다. 오류가 늘수록 평균 응답시간 막대는 줄고 TPS 막대는 늘어나요. 오류가 약 10.5%만 돼도 TPS가 목표 1,000을 넘고, 20%에서는 평균 162ms, TPS 1,111로 두 목표를 모두 통과합니다. 평균과 TPS만 적은 보고서에서는 합격이에요.
그런데 셋째 줄의 성공한 요청만 센 TPS는 900에서 889로 오히려 줄었습니다. 사용자 다섯 명 중 한 명은 오류를 받고 있고요. 오류율을 같이 적지 않으면 이런 시험도 합격으로 남습니다.
측정 도구가 느린 구간을 건너뛰기도 합니다
마지막은 숫자 자체가 아니라 숫자를 만드는 방식입니다. 부하를 거는 방식은 크게 둘로 나뉩니다. 이 글에서는 이렇게 부르겠습니다.
- 응답 대기 방식(closed model): 응답을 받은 뒤에 다음 요청을 보냅니다. 앞에서 본 VU 시험이 이 방식이에요.
- 시각 고정 방식(open model): 응답과 상관없이 정해진 시각에 요청을 보냅니다. 초당 10건이면 0.1초마다요.
k6 문서도 두 방식을 구분합니다. constant-vus는 응답 대기 방식이고 constant-arrival-rate와 ramping-arrival-rate는 시각 고정 방식이에요. 문서는 응답 대기 방식에서 서버가 느려지면 새 요청이 줄어서, 서버가 받는 부하가 함께 줄어든다고 설명합니다.
30초 시험 중 10초부터 15초까지 서버가 5초 멈춘다고 가정해 보겠습니다. 목표는 초당 10건이고, 정상일 때 응답은 50ms입니다. 같은 서버를 두 방식으로 재면 어떻게 다를까요?

위쪽 줄(응답 대기 방식)에서는 10초에 보낸 요청 하나만 5초 넘게 걸렸다고 남습니다. 요청이 응답을 기다리는 동안에는 다음 요청을 보내지 않으니, 멈춘 5초 동안 보냈어야 할 49건은 기록 자체가 없어요. 아래쪽 줄(시각 고정 방식)에서는 멈춘 동안에도 0.1초마다 요청이 들어와서 50건이 차례로 늦어집니다.
결과는 위가 251건에 평균 70ms, p99 50ms이고 아래는 300건에 평균 475ms, p99 4,750ms입니다. 같은 서버가 똑같이 멈췄는데도 위의 숫자만 보면 p99 50ms라서 아무 일도 없었던 것처럼 보입니다. 최대값 5,050ms에만 흔적이 남아요. 사용자가 서버 상태와 상관없이 도착하는 서비스라면 사용자가 겪는 것에 가까운 쪽은 아래입니다.
이 현상은 Gil Tene이 coordinated omission이라고 이름 붙였습니다. 그가 만든 wrk2는 요청이 나갔어야 할 시각부터 응답시간을 재서 이 문제를 보정해요. 응답 대기 방식이 틀렸다는 뜻은 아닙니다. 사용자 수가 정해져 있고 응답을 받은 뒤에 다음 행동을 하는 서비스라면 오히려 실제에 가까울 수 있어요. 어느 방식으로 쟀는지를 적지 않으면 숫자를 해석할 수 없다는 뜻입니다. 그림의 예는 차이를 보이려고 단순하게 만든 모델이라, 멈춘 뒤 요청을 어떻게 다시 보내는지는 도구마다 다릅니다.
p99도 요청이 적으면 흔들립니다
p99를 쓰라고 했지만 p99에도 한계가 있습니다. 요청이 100건이면 p99는 두 번째로 느린 요청이에요. 느린 요청이 한 건 이하로 들어오면 p99가 빠른 쪽으로 내려앉습니다.
서비스 B처럼 느린 요청이 4%인 서비스를 요청 수만 바꿔서 시험 200번씩 반복해 봤습니다. 시뮬레이션이고, 점 하나가 시험 한 번의 p99입니다.
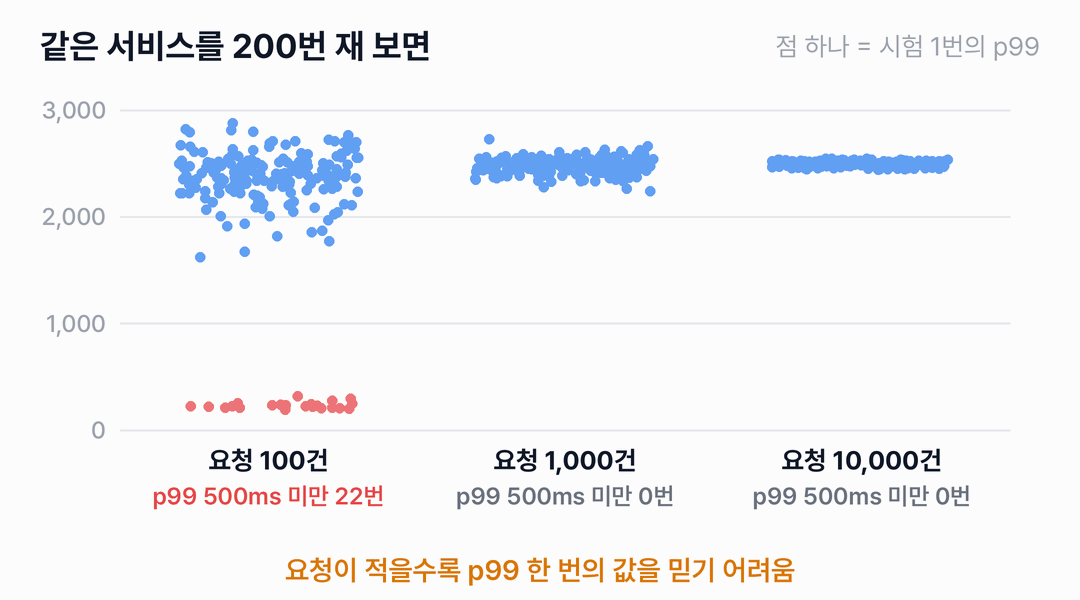
요청 100건일 때는 시험 200번 중 22번의 p99가 500ms 아래(200~300ms 안팎)로 나왔습니다. 느린 요청이 한 건 이하였던 시험이에요. 계산으로도 100건 중 느린 요청이 1건 이하일 확률이 8.7%라서, 200번이면 17번 안팎이 나옵니다. 1,000건에서는 이런 시험이 한 번도 없었고, 10,000건에서는 값이 좁은 띠로 모였어요.
몇 건이면 충분한지는 느린 요청의 비율에 따라 달라서 정해진 숫자가 없습니다. p99를 적을 때는 요청 수를 같이 적고, 시험을 몇 번 반복해서 값이 흔들리는지 확인합니다.
보고서에는 이렇게 적습니다
지금까지 본 것을 보고서에 적을 항목으로 바꾸면 이렇습니다.
| 적을 것 | 이유 |
|---|---|
| 부하를 거는 방식, VU 수 또는 초당 요청 수 | 같은 서버도 방식에 따라 느린 구간이 숫자에서 사라집니다. |
| p50, p95, p99, 최대 | 평균은 느린 요청을 숨깁니다. |
| 요청 수 | 요청이 적으면 p99가 흔들립니다. |
| 오류율과 성공 응답만의 응답시간 | 빨리 돌아오는 오류가 평균과 TPS를 좋게 만듭니다. |
| TPS와 그때의 p99 | TPS가 멈춘 뒤에도 응답시간은 늘 수 있습니다. |
| 화면 하나가 부르는 호출 수 | 호출이 많을수록 느린 요청을 만날 확률이 커집니다. |
서버가 여러 대이거나 시간을 나눠서 잴 때는 p99끼리 평균을 내지 않습니다. 요청 900건이 모두 100ms인 서버와 요청 100건이 모두 1,000ms인 서버의 p99는 100ms와 1,000ms예요. 둘의 평균은 550ms지만 1,000건을 합쳐서 구한 p99는 1,000ms입니다. 원본 응답시간이나 구간별 히스토그램을 합친 다음에 다시 계산해야 합니다.
합격 기준도 같은 모양으로 바꿉니다. ‘평균 300ms 이하’ 대신 ‘p99 500ms 이하이고 오류율이 목표 이하’처럼요. 이 글의 500ms는 설명을 위한 값이고, 서비스마다 사용자가 느리다고 느끼는 기준을 따로 정해야 합니다.
다시, 결제 API로
처음 보고서로 돌아가 보겠습니다. 평균 200ms와 최대 TPS 1,260은 사실일 수 있습니다. 다만 그 평균이 서비스 B처럼 생긴 분포라면 요청 100건 중 4건은 2초 넘게 기다리고 p99는 2.4초입니다. 화면 하나가 호출을 여러 개 부르면 그 4%를 만나는 화면이 훨씬 많아져요. 오류율과 측정 방식은 보고서에 아예 없었고요.
이 글의 그림에서 가져갈 것은 세 가지입니다.
- 평균 옆에 p99를 적습니다. 평균이 같은 A와 B의 p99는 340ms와 2,421ms였습니다.
- TPS 옆에 그때의 p99와 오류율을 적습니다. TPS 1,225와 1,262의 p99는 65ms와 1,074ms였고, 오류 20%에서는 TPS 목표를 넘고도 사용자 다섯 명 중 한 명이 오류를 받았습니다.
- 숫자를 어떻게 만들었는지 적습니다. 같은 5초 멈춤이 p99 50ms로도, 4,750ms로도 기록됐습니다.
남은 질문은 기준입니다. p99로 충분한지, 서비스에 따라 p99.9까지 봐야 하는지는 서비스와 사용자가 정할 일이에요. 그림은 모두 예시 데이터와 시뮬레이션이라서, 실제 서비스에서 이런 모양의 분포가 나오는지는 직접 재 봐야 압니다.