
비싼 GPU 없이 만든 상품 검색 시스템
상품 이미지와 검색 키워드로 상품 검색을 만든 이야기.
쇼핑몰 검색창에 ‘흰색 운동화’를 치면 상품명에 그 글자가 들어간 상품이 나옵니다. 그런데 ‘화이트 스니커즈’는 안 나와요. 같은 흰 운동화인데 글자가 하나도 겹치지 않거든요. 사진을 올려서 비슷한 상품을 찾는 건 아예 할 수 없고요.
일반적으로는 이 문제를 해결하기 위해 이미지 모델을 돌릴 GPU 서버, 벡터를 저장할 벡터 DB, 단어 검색과 순위를 맡을 검색 엔진까지 구축합니다. 하지만 상품 수와 검색량이 크지 않은 쇼핑몰이라면 계산이 달라집니다. T4 GPU 한 장을 한 달 내내 켜 두는 것만으로 Modal(제가 자주 사용하는 서버리스 GPU) 단가 기준 약 425달러가 나가죠.
그래서 저희는 서버를 늘리지 않는 쪽으로 검색을 직접 만들었습니다. 상품 사진은 등록할 때 한 번만 읽고, 벡터는 상품 테이블에 함께 넣고, 순서는 점수 규칙으로 정합니다. 상품 1만 개, 검색어 검색 월 10만 번을 가정하면 추가 비용은 첫 등록에 약 1.70달러, 그 뒤로 한 달 약 0.24달러입니다.
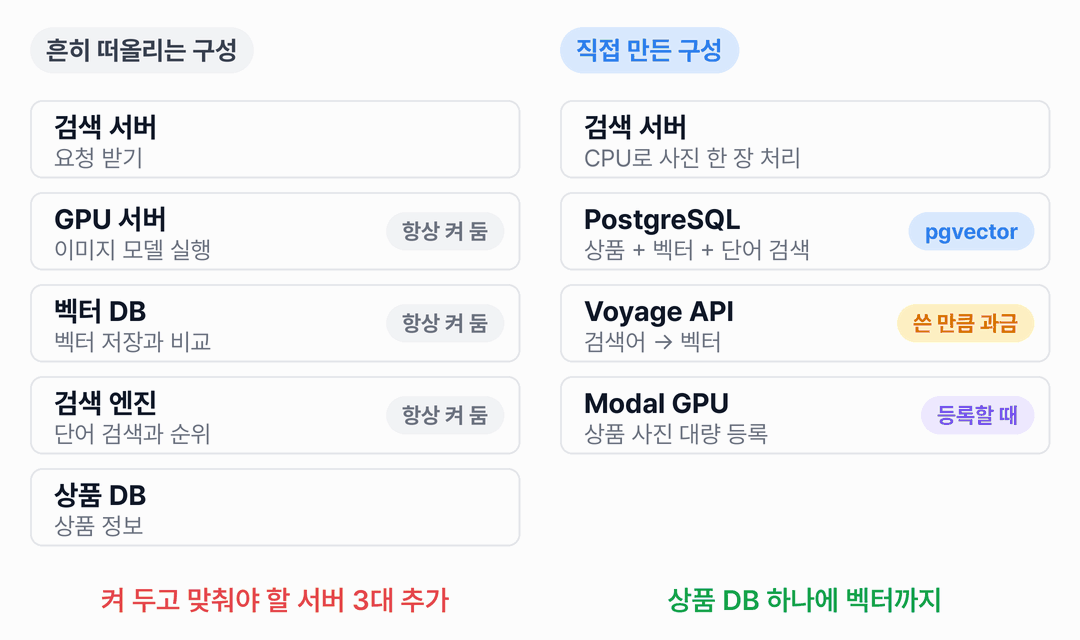
왼쪽은 흔히 떠올리는 구성이고, 오른쪽이 저희가 만든 구성입니다. 오른쪽에는 ‘항상 켜 둠’ 표시가 없어요. 벡터는 상품 DB에 함께 들어가고, GPU는 사진을 대량으로 등록할 때 빌려 쓰고, 검색어 벡터는 쓴 만큼 돈을 내는 API로 만듭니다.
키워드 검색은 같은 운동화를 놓칩니다
키워드 검색은 상품명에 검색어 글자가 들어 있는지만 봅니다. ‘흰색’과 ‘운동화’가 모두 들어간 상품을 찾는 키워드 검색을 예시 상품 네 개에 직접 돌려 보면 바로 보입니다.

화이트 스니커즈 B는 같은 흰 운동화인데도 글자가 하나도 겹치지 않아 빠집니다. 사진은 글자가 아니라서 넣을 자리조차 없고요.
두 문제 모두 글자 대신 생김새나 뜻을 비교해야 풀립니다. 그러려면 사진과 글을 서로 비교할 수 있는 숫자로 바꿔야 해요.
검색은 두 단계로 나눴습니다
상품 전체를 한 번에 줄 세우지는 않고, 두 단계로 나눠보겠습니다.
- 후보 모으기(Retrieval): 전체 상품 중 관련 있어 보이는 상품을 넉넉히 가져옵니다.
- 순서 정하기(Ranking): 모은 후보만 놓고 보여줄 순서를 정합니다.
상품이 1만 개여도 후보 모으기가 수백 개만 남기면, 순서 정하기는 그 수백 개만 계산하면 됩니다.
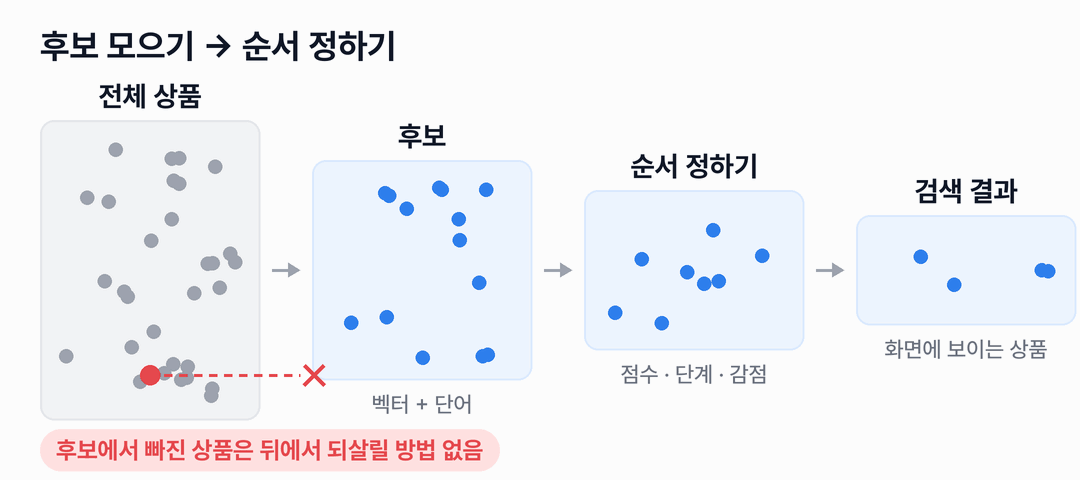
그림의 빨간 점이 이 구조에서 가장 조심할 부분입니다. 원하는 상품이 후보 모으기에서 빠지면, 순서 정하기가 아무리 정확해도 결과에 나오지 않아요.
사진은 숫자 목록으로 바꿔서 비교합니다
사진 두 장이 비슷한지 컴퓨터가 판단하려면 비교할 수 있는 형태가 필요합니다. 픽셀을 그대로 비교하면 잘 안 맞아요. 같은 운동화도 각도나 조명이 바뀌면 픽셀이 전부 달라지고, 흰 배경에 놓인 흰 신발끈과 흰 운동화는 오히려 픽셀이 비슷하거든요.
그래서 이미지 모델을 씁니다. 이미지 모델은 사진 한 장을 받아 숫자 수백 개로 된 목록을 돌려줍니다. 이 목록을 벡터, 또는 임베딩(embedding)이라고 부릅니다. 저희가 쓴 모델은 사진과 그 사진을 설명하는 글이 비슷한 숫자 목록이 되도록 학습한 모델이라, 비슷한 물건을 찍은 사진끼리도 비슷한 숫자 목록이 나옵니다.

같은 운동화를 다른 각도로 찍은 두 사진은 목록이 거의 같아서 유사도가 0.99입니다. 신발끈 사진은 목록이 꽤 달라서 0.59고요. 숫자 하나하나에 ‘색’이나 ‘모양’ 같은 뜻이 붙어 있지는 않습니다. 쓸모 있는 건 두 목록 사이의 거리예요.
모델은 SigLIP입니다. 공개된 모델이라 내려받아 서버에서 직접 돌립니다. 호출할 때마다 돈을 내는 API가 아니에요. 사진 한 장을 벡터로 바꾸는 코드는 이 정도입니다. 이미지를 불러오는 부분과 오류 처리는 뺐습니다.
1
2
3
4
5
6
7
8
9
model, _, preprocess = open_clip.create_model_and_transforms(
    "ViT-B-16-SigLIP", pretrained="webli"
)
model.eval()

image_tensor = preprocess(image.convert("RGB")).unsqueeze(0)
with torch.no_grad():
    vector = model.encode_image(image_tensor)
    vector = vector / vector.norm(dim=-1, keepdim=True)
마지막 줄은 벡터의 길이를 1로 맞춥니다. 왜 맞추는지는 조금 뒤에 나와요.
한 가지 꼭 지켜야 할 게 있는데요. 상품 사진과 검색 사진은 반드시 같은 모델로 바꿔야 합니다. 모델이 다르면 같은 사진이라도 전혀 다른 숫자가 나와서 비교할 수 없거든요. 뒤에 나올 검색어 벡터를 사진 벡터와 다른 컬럼에 저장하는 것도 같은 이유입니다.
사진은 등록할 때 한 번만 읽습니다
이미지 모델을 돌리는 건 무거운 일입니다. 검색할 때마다 상품 사진 전부를 모델에 넣는다면 상품이 늘수록 감당하기 어려워져요.
그런데 상품 사진은 어떤 검색이 들어와도 그대로입니다. 그러니 미리 바꿔 두면 됩니다. 상품을 등록할 때 사진을 벡터로 바꿔 저장해 두고, 검색할 때는 사용자가 올린 사진 한 장만 벡터로 바꿔서 저장된 벡터와 비교합니다.

위쪽 ①이 등록, 아래쪽 ②가 검색입니다. 등록할 때는 사진 여덟 장이 모두 모델을 거치지만, 검색이 #1, #2로 반복되는 동안 모델을 거치는 사진은 매번 한 장이에요. 위쪽은 한 번 움직이고 멈춥니다.
상품 수에 따라 그려 보면 차이가 더 분명합니다. 가로축은 상품 수, 세로축은 검색 한 번에 모델이 처리하는 사진 수입니다.

매번 전부 바꾸면(빨간 선) 상품이 10만 개일 때 10만 장을 읽어야 합니다. 미리 바꿔 두면(파란 선) 상품이 몇 개든 1장이죠.
사진은 한 번 읽고, 검색은 한 장만 읽습니다.
검색 서버는 이 한 장을 CPU로 처리합니다. 그래서 검색 서버에는 GPU가 필요 없어요. 사진을 한꺼번에 많이 등록할 때는 Modal이라는 클라우드 서비스의 T4 GPU를 씁니다. 두 곳 모두 같은 모델과 같은 전처리를 쓰기 때문에, 어디서 만든 벡터든 서로 비교할 수 있습니다.
검색어까지 합쳐 각 작업이 언제, 어디서 실행되는지 정리하면 이렇습니다.
| 하는 일 | 언제 | 어디서 |
|---|---|---|
| 상품 사진 → 벡터 | 미리, 한 번 | Modal의 T4 GPU (대량 등록) |
| 상품명과 키워드 → 벡터 | 미리, 한 번 | Voyage API |
| 검색 사진 → 벡터 | 사진 검색마다 | 검색 서버의 CPU |
| 검색어 → 벡터 | 검색어 검색마다 | Voyage API |
| 후보 모으기 | 검색마다 | PostgreSQL |
| 순서 정하기 | 검색어 검색마다 | 검색 서버 |
검색어 검색은 검색할 때마다 Voyage API를 한 번 호출합니다. 글자용 모델을 직접 돌리지 않는 대신 쓴 만큼 요금을 내는 거죠.
가까운 상품은 PostgreSQL이 찾습니다
두 벡터가 얼마나 가까운지는 방향으로 잽니다. 화살표 두 개가 같은 쪽을 가리키면 비슷하고, 벌어질수록 다릅니다. 이 벌어진 정도를 숫자로 나타낸 게 코사인 유사도예요. 같은 방향이면 1, 직각이면 0, 정반대면 -1입니다.
아래는 숫자가 두 개뿐인 벡터로 그린 예시입니다. 검은 화살표가 검색 벡터이고, 오른쪽 목록은 P, Q, R과의 유사도를 큰 순서로 보여줍니다. 점선은 두 벡터의 한가운데예요.

검색 벡터가 P와 Q의 한가운데인 50°를 넘으면 Q가 P를 앞서고, 115°를 넘으면 R이 Q를 앞섭니다. 실제 벡터는 숫자가 수백 개라 그림으로 그릴 수 없지만, 계산 방법은 같아요.
그럼 숫자가 수백 개일 때는 어떻게 계산할까요? 앞에서 벡터 길이를 1로 맞춘 게 여기서 쓰입니다. 길이가 모두 1이면, 같은 자리의 숫자끼리 곱해서 모두 더한 값(내적)이 곧 코사인 유사도입니다.

여섯 자리를 곱한 0.25, 0.07, 0.22, 0.01, 0.25, 0.17을 모두 더하면 0.97입니다. 숫자가 수백 개여도 곱하고 더하는 횟수만 늘어날 뿐이에요.
다음은 이 계산을 어디서 하느냐입니다. 저희는 벡터 전용 DB를 따로 두지 않고 상품 테이블에 벡터 컬럼을 추가했습니다. PostgreSQL에 pgvector 확장을 설치하면 벡터를 저장하고 거리를 계산할 수 있거든요. 사진 검색 쿼리는 이렇게 생겼습니다.
1
2
3
4
5
SELECT id, 1 - (embedding <=> :query_vector) AS similarity
FROM products
WHERE embedding IS NOT NULL
ORDER BY embedding <=> :query_vector
LIMIT :candidate_limit;
<=>는 두 벡터의 코사인 거리를 구하는 연산자입니다. 거리는 1 - 유사도라서, 유사도가 0.97이면 거리는 0.03이에요. 거리가 작은 순서로 정렬해서 앞에서부터 정해진 개수만 가져옵니다. 상품 여덟 개로 보면 이렇습니다.

같은 사진을 쓰는 운동화 A와 A 복제는 거리도 0.03으로 같습니다. 이 둘이 나란히 올라오는 문제는 뒤에서 다시 다룰게요. 그리고 LIMIT 선 아래의 상품은 다음 단계로 넘어가지 못합니다. 앞에서 본 빨간 점이 바로 이 경우예요.
상품 정보와 벡터가 같은 줄에 있으니 따로 맞춰 줄 데이터도 없습니다. 상품을 지우면 벡터도 같이 지워지고, 아직 벡터가 없는 상품은 WHERE embedding IS NOT NULL로 걸러져요. 연산자와 계산식은 pgvector 문서에 정리되어 있습니다.
다만 유사도 0.9가 ‘같은 상품일 확률 90%’라는 뜻은 아닙니다. 모양이 비슷한 다른 상품이나 배경이 비슷한 사진도 높게 나오죠.
검색어는 두 번 찾아서 합칩니다
검색어도 같은 방식입니다. 상품명과 키워드를 미리 벡터로 바꿔 두고, 검색어가 들어오면 그것만 벡터로 바꿔 비교합니다. 글자용 모델은 Voyage의 voyage-multilingual-2인데, 사진용 모델과 다르기 때문에 벡터도 다른 컬럼에 저장합니다.
글자를 벡터로 비교하면 표기가 달라도 뜻이 비슷한 상품이 가까이 옵니다. 검색어 주변에 무엇이 모이는지 개념도로 보면 이렇습니다.
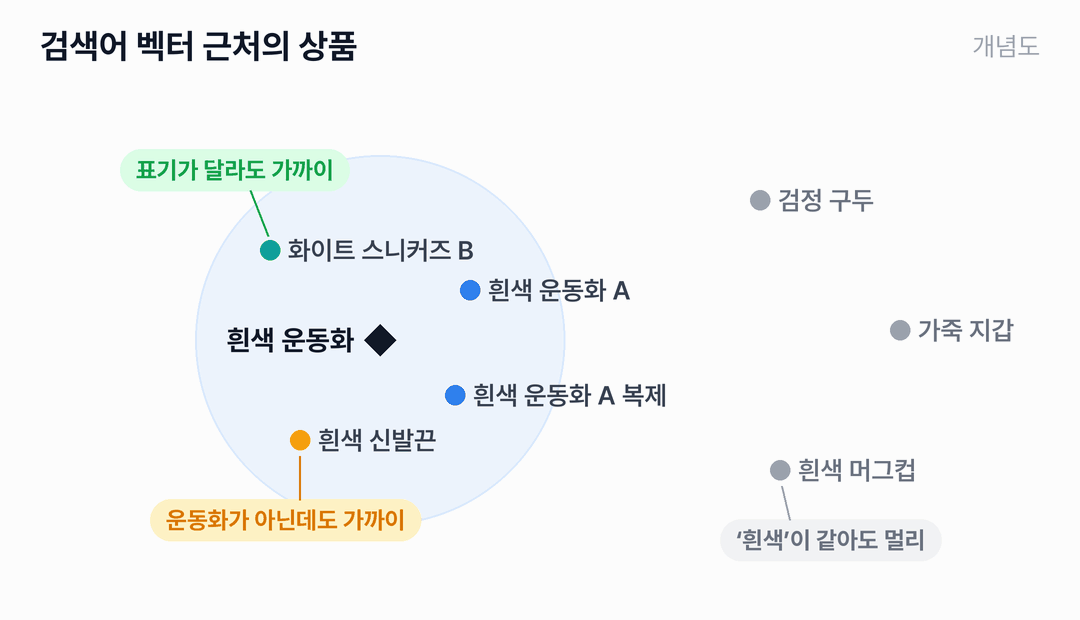
‘화이트 스니커즈 B’는 글자가 하나도 겹치지 않아도 가깝습니다. 키워드 검색이 놓친 상품을 찾을 수 있는 이유죠. 반대로 ‘흰색 머그컵’은 ‘흰색’이 같아도 멀리 있습니다. 그런데 ‘흰색 신발끈’처럼 운동화와 늘 같이 다니는 물건도 원 안에 들어와요. 이건 뒤에서 순서를 정할 때 풀겠습니다.
그렇다면 벡터만으로 후보를 모으면 충분할까요? 아쉽게도 아닙니다. 벡터 검색은 가까운 순서로 정해진 개수만 가져오기 때문에, 이름에 검색어가 그대로 들어 있는 상품이라도 순위에서 밀리면 빠집니다. 그래서 검색어는 두 가지 방법으로 찾아서 합칩니다.
- 벡터로 찾기: 검색어 벡터와 가까운 상품
- 단어로 찾기: 이름이나 키워드에 검색어 단어가 들어 있는 상품
아래 예시에서는 ‘화이트’가 ‘흰색’과, ‘스니커즈’가 ‘운동화’와 같은 말로 묶여 있고, 벡터로는 두 개만 가져온다고 가정했습니다.

②번 장면을 보면, 스니커즈 B는 두 단어가 다 맞는데도 벡터 유사도가 0.920으로 넷 중 가장 낮아 빠집니다. 단어로 찾으면 B가 들어오고, 합치면 네 상품이 모두 후보가 돼요. 양쪽에서 다 찾은 운동화 A는 한 번만 들어갑니다. 신발끈도 아직 남아 있는데, 순서는 이 단계에서 정하지 않습니다.
실제로는 두 방법이 각각 max(200, 요청한 결과 수 × 4)개까지 가져옵니다. 결과를 20개 요청하면 20 × 4 = 80보다 200이 크니 각각 200개씩, 합쳐서 많아야 400개가 후보가 됩니다. 100개를 요청하면 각각 400개씩이고요. 두 목록은 SQL 하나 안에서 합칩니다. 두 방법이 같은 테이블을 보니까 가능한 일이에요. 구조만 남기면 이렇습니다.
1
2
3
4
5
6
7
8
9
10
WITH semantic AS (
    -- 텍스트 벡터가 가까운 상품 ID
), lexical AS (
    -- 상품명과 키워드가 일치하는 상품 ID
), candidates AS (
    SELECT id FROM semantic
    UNION
    SELECT id FROM lexical
)
-- 후보의 이름, 키워드, 벡터를 가져와 순위 계산에 사용
단어로 찾을 때는 몇 가지 규칙이 있습니다. ‘운동화’와 ‘스니커즈’처럼 뜻이 같은 단어는 사전에 묶어 둡니다. 사전에 없는 말은 묶이지 않아요. 짧은 단어도 조심해야 합니다. ‘아이’를 찾는데 ‘아이스’까지 걸리면 곤란하니까, 일부 짧은 단어는 단어 단위로 맞는지 확인합니다.
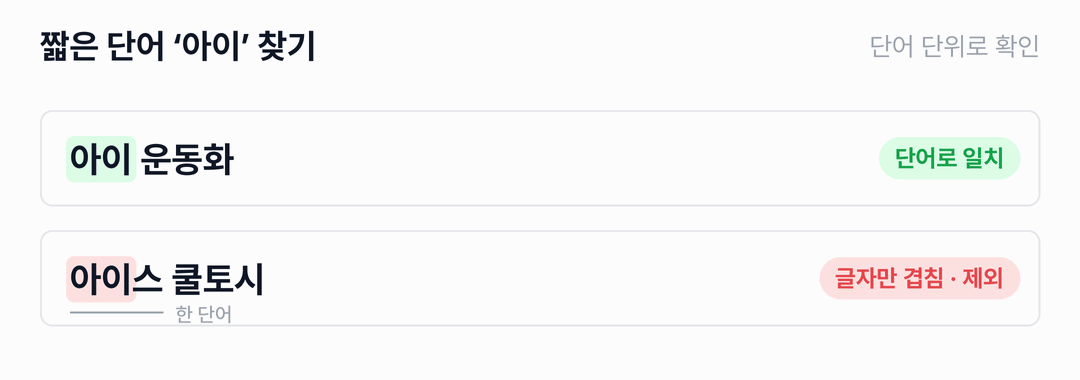
후보 개수는 비용과 결과 사이에서 정하는 값입니다. 많이 가져오면 놓치는 상품은 줄지만 DB에서 읽을 행과 순서 정하기에서 계산할 양이 늘어나요. 너무 적으면 앞의 빨간 점처럼 원하는 상품이 후보에 못 들어옵니다.
신발끈은 점수로 내립니다
후보를 모았으면 순서를 정합니다. 그런데 유사도 순으로만 줄 세우면 두 가지 문제가 생기는데요. 첫째는 신발끈이 운동화보다 먼저 나오는 겁니다. 예시에서 유사도가 가장 높은 상품은 흰색 신발끈(0.995)이에요.
그래서 유사도에 두 가지를 더 반영합니다.
- 단어 일치: 검색어 단어가 몇 개 맞는가. ‘흰색 운동화’는 두 묶음이라 둘 다 맞으면 1, 하나만 맞으면 0.5입니다.
- 종류 일치: 상품 종류가 맞는가. 신발끈은 운동화와 관련은 있어도 운동화는 아니니 0입니다.
상품 종류를 알아낸 검색어에서는 점수를 이렇게 계산합니다.
1
2
3
4
5
score = (
    0.60 * cosine_similarity
    + 0.25 * matched_groups / total_groups
    + 0.15 * type_match
)
운동화 A는 0.60 × 0.98 + 0.25 × 1 + 0.15 × 1 = 0.988이고, 신발끈은 0.60 × 0.995 + 0.25 × 0.5 + 0.15 × 0 = 0.722입니다. 막대 하나가 상품 하나이고, 파란 조각이 유사도, 보라 조각이 단어, 초록 조각이 종류예요.

파란 조각만 보면 넷이 거의 같습니다. 보라와 초록을 더하면 신발끈만 짧게 끝나서 맨 아래로 내려가죠.
점수 위에는 단계도 있습니다. 상품번호가 정확히 맞는 상품, 검색어 단어가 모두 맞는 상품, 종류만 맞는 상품, 나머지 순으로 단계를 나누고, 같은 단계끼리만 점수로 비교합니다. 종류를 알아내지 못한 검색어에는 다른 가중치를 씁니다.
같은 사진은 뒤로 미룹니다
두 번째 문제는 같은 상품이 첫 화면을 채우는 겁니다. 같은 사진을 쓰는 상품이 여러 개면 점수도 비슷해서 나란히 올라와요. 위 점수에서도 운동화 A(0.988)와 A 복제(0.982)가 1, 2등입니다.
그래서 결과를 하나씩 고르면서, 이미 고른 상품과 많이 겹치는 후보는 점수를 깎습니다. 겹치는 정도는 세 가지로 봅니다.
- 벡터: 두 상품의 벡터가 얼마나 비슷한가
- 이름: 상품명에 같은 단어가 얼마나 있는가
- 사진: 같은 사진 주소를 쓰는가
이름이 겹치는 정도는 Jaccard 유사도로 잽니다. 두 이름에 함께 나오는 단어 수를, 두 이름에 나온 단어를 중복 없이 모은 수로 나눈 값이에요. 사진이 같으면 이름과 상관없이 겹침을 1로 봅니다.
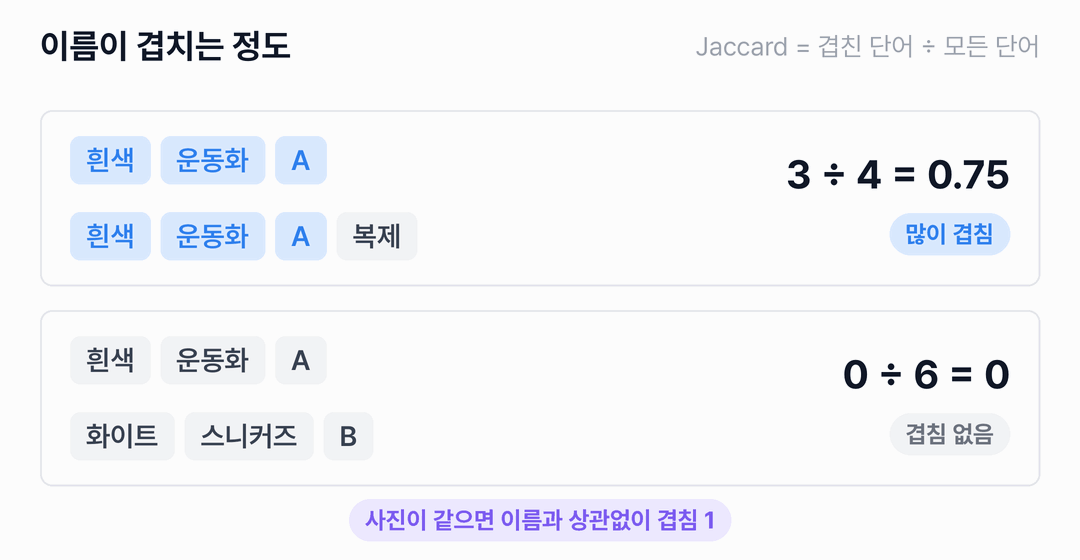
‘흰색 운동화 A’와 ‘흰색 운동화 A 복제’는 단어 넷 중 셋이 겹쳐 0.75, ‘화이트 스니커즈 B’와는 겹치는 단어가 없어 0입니다.
이제 같은 네 후보를 세 번 줄 세워 볼게요. ① 유사도만, ② 단어와 종류 반영, ③ 겹침 감점 순서입니다.

③에서 B와 A 복제가 자리를 바꿉니다. 운동화 A를 먼저 고르면 같은 사진을 쓰는 A 복제는 0.080이 깎이고, 사진도 이름도 다른 B는 0.039가 깎여요. 원래 점수는 A 복제 0.982, B 0.952로 0.030 차이였는데, 깎인 양의 차이(0.041)가 더 커서 B가 앞섭니다.
계산 부분만 옮기면 아래와 같습니다.
1
2
3
4
overlap = max(name_jaccard, float(same_image))
penalty = strength * (0.5 * vector_similarity + 0.5 * overlap)
redundancy = max(previous_redundancy, penalty)
priority = tier + score - redundancy
깎는 세기 strength는 검색어 묶음이 하나면 0.3, 여러 개면 0.08입니다. 예시는 두 묶음이라 0.08을 썼고, 이 예시에서는 감점 때문에 신발끈이 운동화를 다시 앞서지는 않습니다.
같은 사진이라고 꼭 같은 상품은 아니고, 이름이 다르다고 다른 상품이라는 보장도 없습니다. 그래서 겹치는 상품을 지우지 않고 한 칸 뒤로 미루기만 합니다.
한 달 비용을 계산해 봤습니다
처음에 말한 숫자가 어디서 나왔는지 보겠습니다. 실제 서비스 사용량은 공개할 수 없어서 아래처럼 가정했고, 단가는 각 서비스의 공식 요금표에서 확인한 값입니다.
| 항목 | 가정 또는 단가 | 근거 |
|---|---|---|
| 상품 | 1만 개, 상품마다 사진 1장 | 예시 |
| 검색어 검색 | 한 달 10만 번, 검색어 하나에 20토큰 | 예시, 토큰은 넉넉히 잡음 |
| 상품명과 키워드 | 상품 하나에 50토큰 | 예시 |
| GPU로 사진 한 장 처리 | 1초 | 측정하지 않아 넉넉히 잡음 |
| Modal T4 GPU (실제 사용) | 1초에 0.000164달러 | Modal 요금표 |
| Voyage voyage-multilingual-2 (실제 사용) | 100만 토큰에 0.12달러 | Voyage 요금표 |
| Pinecone Standard | 한 달 최소 50달러 (무료·20달러 요금제도 있음) | Pinecone 요금표 |
계산은 단순합니다.
- GPU를 한 달 내내 켜 두면: 0.000164달러 × 60초 × 60분 × 24시간 × 30일 = 425.09달러
- 첫 등록(사진): 사진 1만 장 × 1초 × 0.000164달러 = 1.64달러
- 첫 등록(상품명): 1만 개 × 50토큰 = 50만 토큰 → 0.06달러
- 매달(검색어): 10만 번 × 20토큰 = 200만 토큰 → 0.24달러
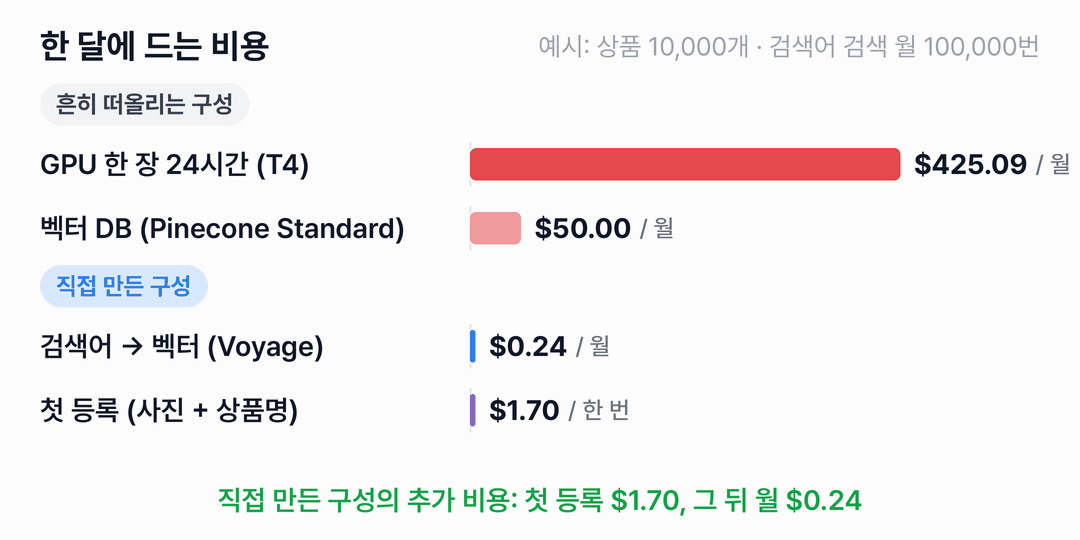
눈여겨볼 건 막대 길이보다 비용이 나가는 방식입니다. 흔한 구성의 비용은 검색이 한 번도 없어도 매달 나가는 고정비예요. 저희 구성의 비용은 등록할 때 한 번, 그리고 검색한 만큼만 나갑니다. 이 가정에서 Voyage 요금이 GPU 한 달 비용과 같아지려면 검색어 검색이 한 달 약 1억 7,700만 번은 돼야 합니다.
저장 공간도 따져 볼까요? pgvector는 벡터 하나에 ‘4 × 차원 + 8’바이트를 씁니다. 사진 벡터(768차원) 3,080바이트와 글 벡터(1,024차원) 4,104바이트를 더하면 상품 하나에 약 7KB, 1만 개면 약 72MB가 상품 테이블에 더해집니다.
이 계산에서 뺀 것도 있습니다.
- 무료 사용량: Modal Starter 요금제의 월 무료 크레딧(30달러)은 넣지 않았습니다. 넣으면 첫 등록 비용은 0원이에요. Voyage 요금표는 voyage-multilingual-2의 무료 토큰을 설명과 표에서 다르게 적고 있어 이것도 넣지 않았습니다.
- GPU 단가: 흔한 구성의 GPU 비용은 Modal의 T4 단가로 한 달 내내 쓴다고 보고 계산했습니다. 클라우드 GPU 서버를 따로 빌리면 업체와 사양에 따라 금액이 달라집니다.
- 검색 서버: 사진 한 장을 CPU로 처리하는 비용은 측정하지 않았습니다. 검색 서버는 두 구성 모두에 있어서 비교에서 뺐어요.
- 검색 엔진: 흔한 구성의 검색 엔진은 사양과 사용량에 따라 요금이 달라 계산하지 않았습니다. 넣으면 차이는 더 커집니다.
대신 사람이 챙길 일이 생겼습니다
서버를 덜 둔 대신 생긴 일도 있습니다.
첫째, 규칙을 사람이 관리해야 합니다. 동의어 사전, 상품 종류, 점수 가중치 모두 사람이 정한 값이에요. 하나를 고치면 어떤 검색어는 좋아지고 다른 검색어는 나빠질 수 있습니다. 그래서 테스트로 이 규칙들을 확인합니다.
- 종류가 맞는 상품이 위에 있는가
- 신발끈 같은 부속품이 앞에 나오지 않는가
- ‘아이’가 ‘아이스’에 걸리지 않는가
- 비슷한 상품이 결과를 다 차지하지 않는가
규칙을 바꿀 때는 예전 검색어도 다시 돌려 봐야 합니다.
둘째, 검색어 검색은 매번 Voyage API를 부릅니다. 호출 비용과 응답 시간은 그 서비스에 달려 있죠.
검색 결과가 이상할 때는 원하는 상품이 후보에 있었는지부터 봅니다. 검색을 두 단계로 나눠 둔 덕분에, 어디를 고쳐야 할지 금방 좁혀져요.
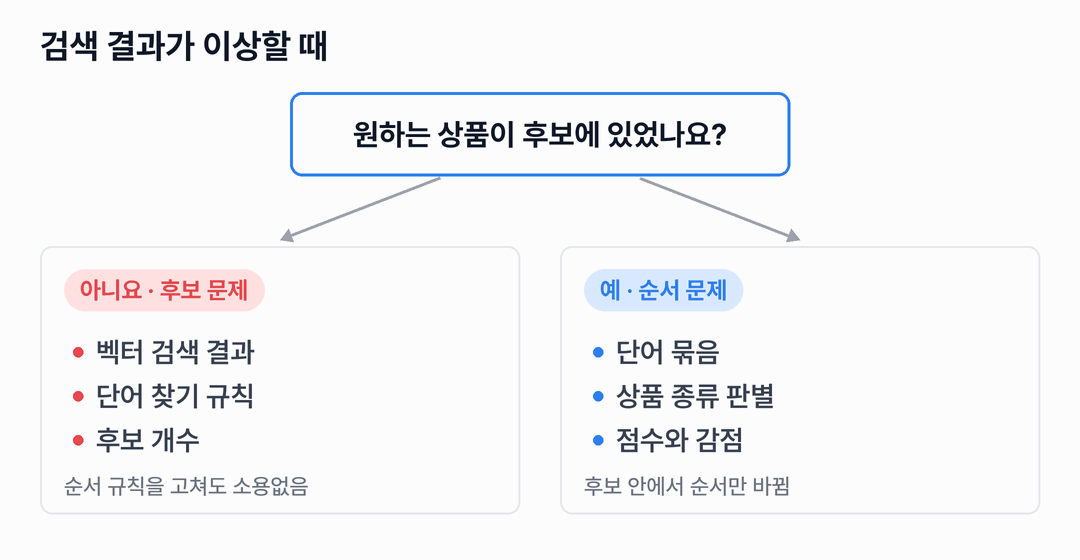
아직 재 보지 않은 것도 있습니다. CPU로 사진 한 장을 처리하는 시간, 검색이 몰릴 때 버티는 정도, 대량 등록 속도는 측정하지 않았어요. 대량 등록은 지금 사진을 한 장씩 차례로 처리합니다. 여러 장을 묶어서 처리하면 빨라질 수 있지만, 얼마나 빨라지는지는 재 봐야 압니다.
GPU 서버도, 벡터 DB도 따로 두지 않았습니다. 무거운 계산은 등록할 때 끝내고, 벡터는 상품 테이블에 넣고, 모델이 구분하지 못하는 것은 점수 규칙과 테스트로 보완했어요. 이제.. 남은 걸림돌은 규모입니다. 상품과 검색이 얼마나 늘어날 때까지 이 구성으로 충분한지는 측정으로 확인해야 할 부분입니다.